
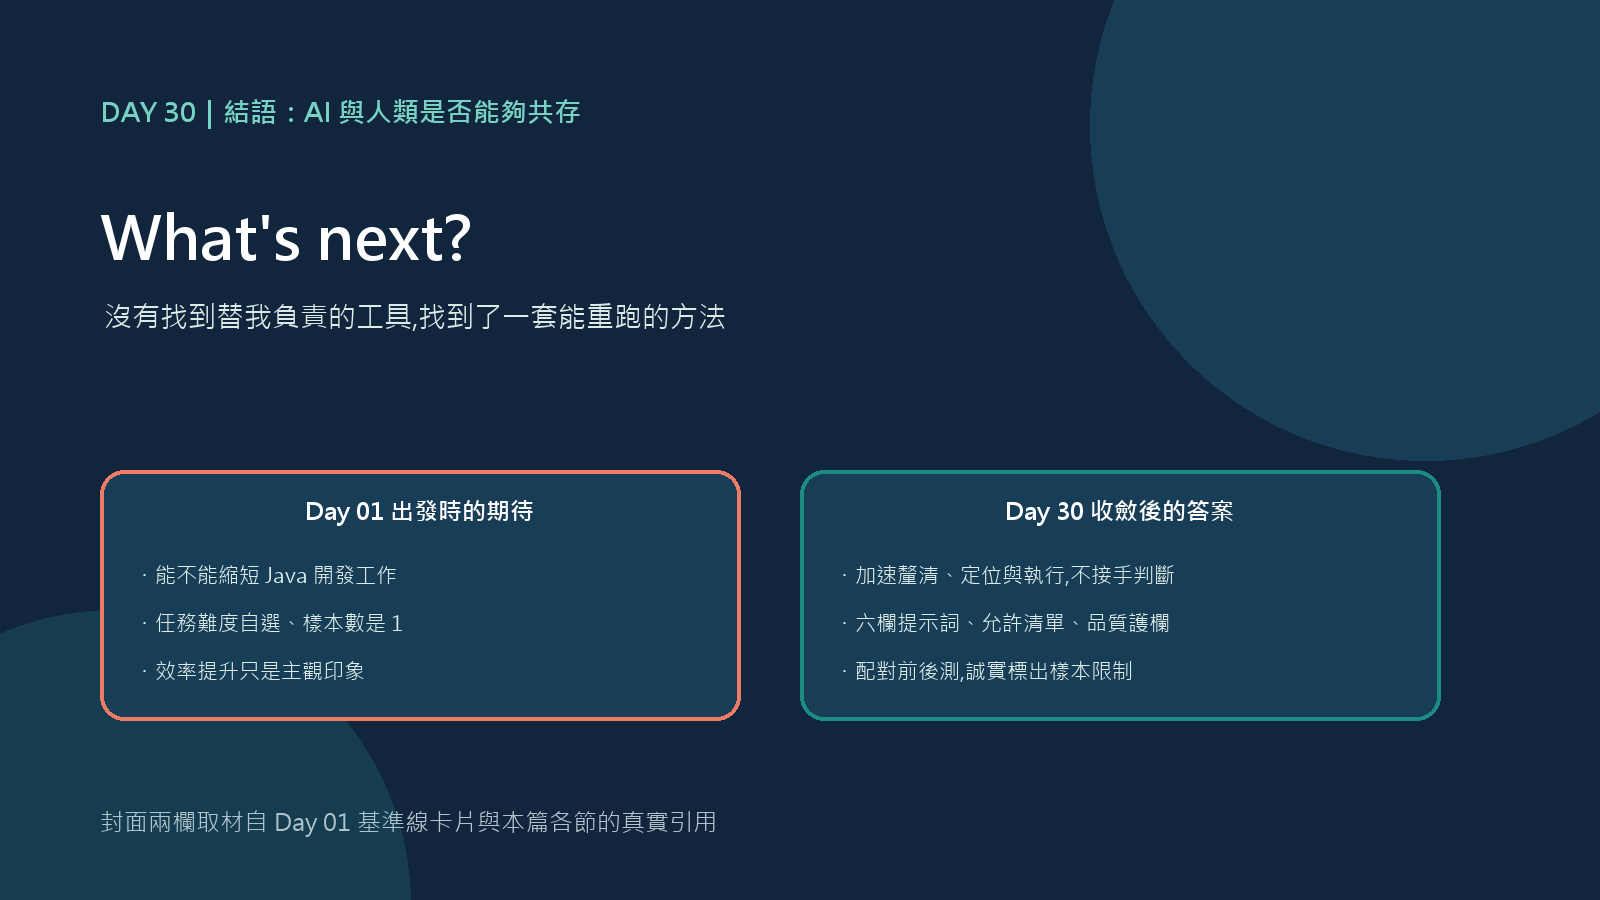
Day 29 用一份配對前後測,把「感覺變快了」換成可追溯的數字:速度提升四成,複核負擔、修改否決比例、引用錯誤數卻同時變差。我翻回 Day 01,那張基準線卡片其實只留了任務與驗收條件、原本完成時間、人工修改或退回次數這幾個開放欄位,難度自選、樣本數是 1,本來就不是能拿來做統計的資料;卡片背後真正想確認的,是那句「ChatGPT 與 Codex 應該放在開發流程的哪個位置,才能節省時間,又保留人工決策」。
30 天後我能給的答案精確一點,也保守一點:ChatGPT 加速的是釐清、比較與草擬;Codex 加速的是定位、修改與跑測試;兩者都不會替我承擔判斷責任,證據齊不齊、範圍準不準,還是要靠交辦與驗收時的人工設計。最出乎意料的不是工具能做到什麼,是 Day 29 那組配對資料:速度確實變快,複核負擔、修改否決比例、引用錯誤數卻同時變差——「效率提升」只看單一指標,很容易得出站不住腳的結論。
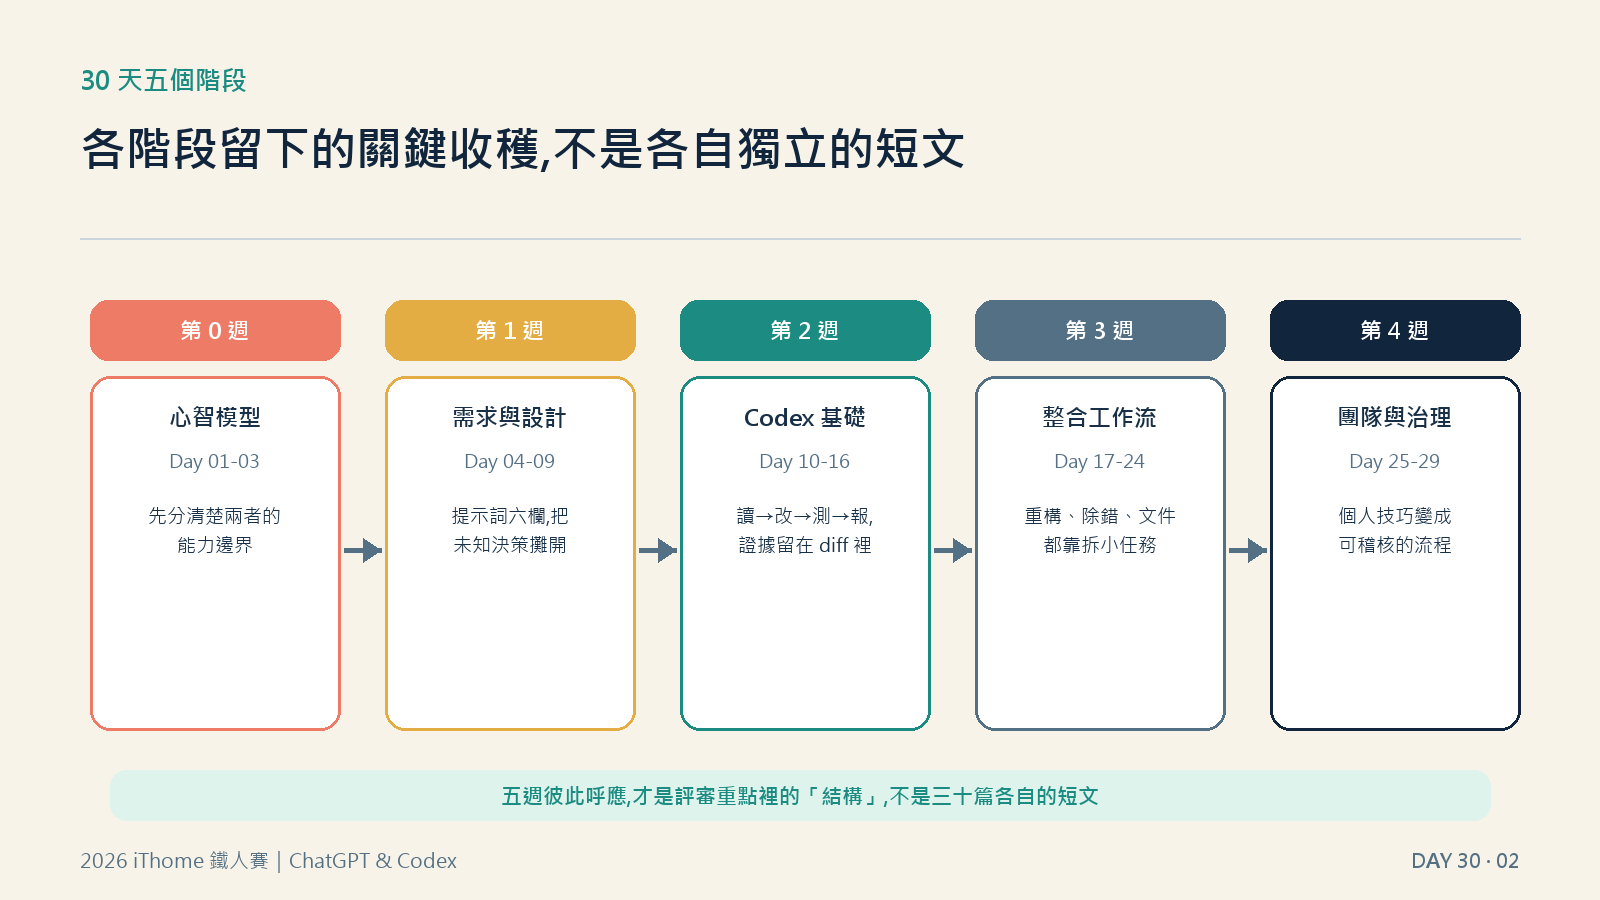
Day 07 那次查詢契約是這系列裡我引用最多次的例子:我沒有讓 ChatGPT 自由發揮,而是先列出決策白名單,限定它只能在 DECISIONS 範圍內整理業務契約,OpenAPI 必填欄位另外取自固定的 DOCUMENT_TEMPLATE。品質改善不是來自提示詞變長,而是未知決策被攤開,有地方可以被否決。Day 13 那次「日期相等被誤判成迄日較早」的修正也是同一件事:先給確切呼叫、現況與可改範圍,Codex 才定位得到 ReportRangeService.java:14 那一行條件,不是亂猜。
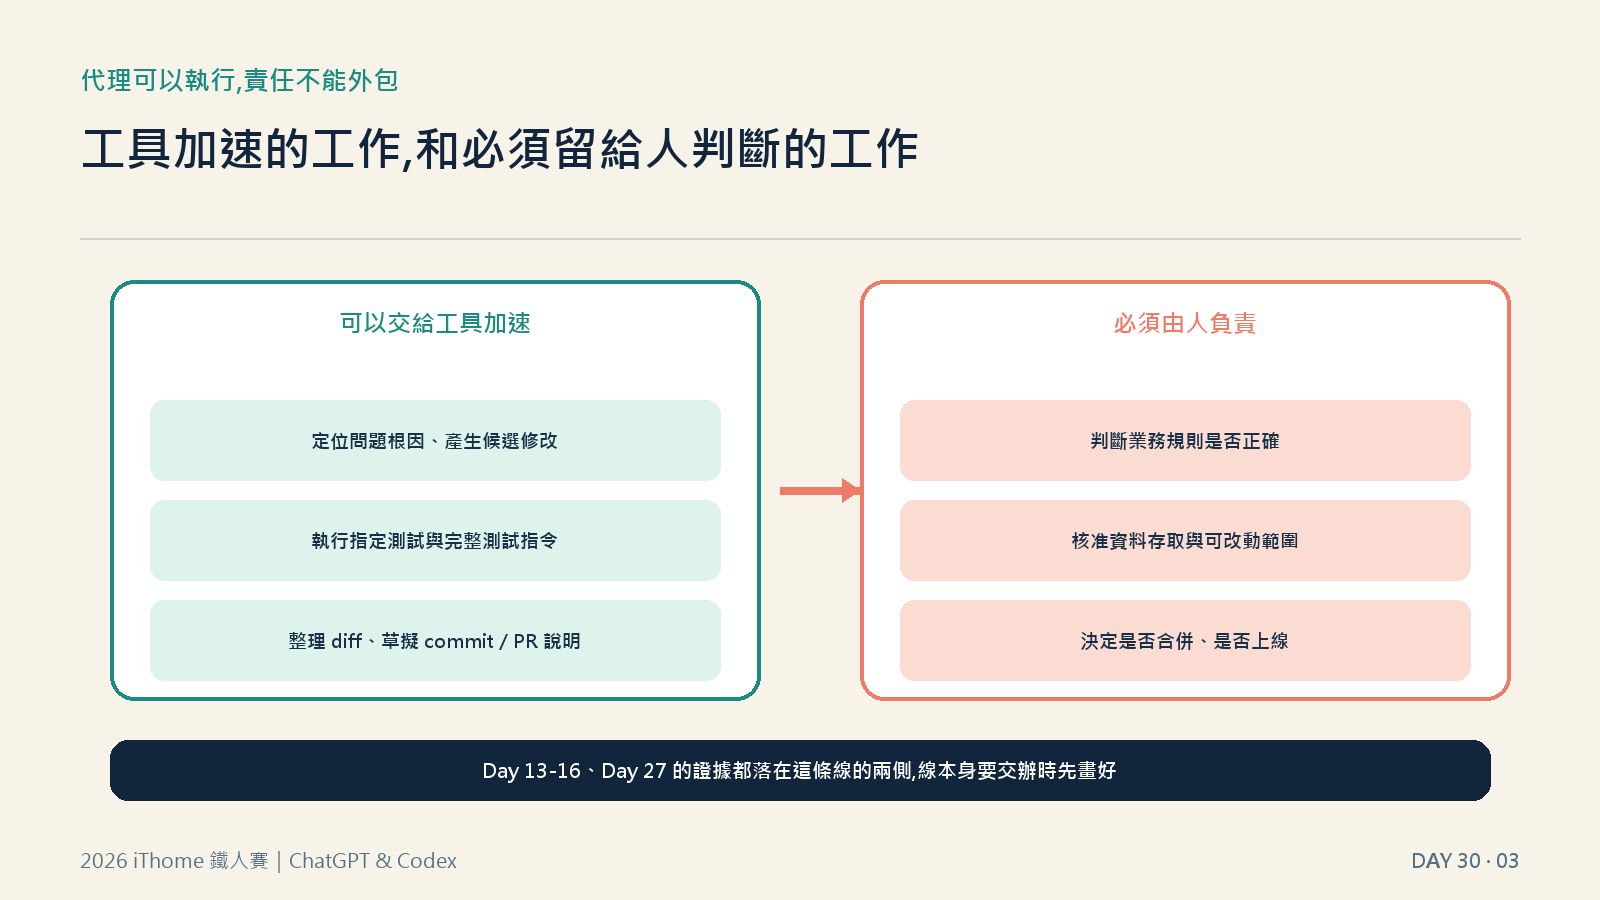
Day 11 到 Day 16 走過的「讀 → 改 → 測 → 回報」,讓我比較有把握區分哪些工作可以放心交給工具,哪些不行:
| 可以交給工具加速 | 必須由人負責 | 本系列證據 |
|---|---|---|
| 定位問題根因、產生候選修改 | 判斷業務規則是否正確 | Day 13 日期條件修正、Day 07 決策白名單 |
| 執行指定測試與完整測試指令 | 核准資料存取與可改動範圍 | Day 15 權限邊界、Day 27 存取控制程式 |
| 整理 diff、草擬 commit/PR 說明 | 決定是否合併、是否上線 | Day 16 分支與 PR 草稿流程 |
Day 12 與 Day 18 補上同一塊拼圖:AGENTS.md 寫下不能為了修缺陷改測試的規則,任務契約再明訂允許修改與禁止修改的檔案清單。Codex 不是惡意「順手」擴大範圍,是交辦沒寫清楚邊界;diff 檔案數對不上預期,是目前我找到最快的訊號,不是唯一的訊號。
| 團隊落地程度 | 對應內容 | 我的判斷 |
|---|---|---|
| 可立即導入 | Day 26 提示詞資產化:用途、輸入、禁止事項、固定輸出、驗收、維護人六欄 | 缺一項就只是個人技巧,補齊才能重跑 |
| 需利害關係人確認 | Day 27 資料分級與六面向治理骨架 | 分級標準本身還沒訂,不能由工程師自行判斷能不能碰 |
| 暫時不適合 | 未經覆核的輸出直接合併、拿真實客戶資料當測試素材 | Day 27 治理骨架要補的缺口,正是這條線沒畫清楚 |
Day 01 那張基準線卡片和 Day 29 的配對前後測,其實不能直接放進同一張表比較——任務範圍、驗收條件、樣本數都不一樣,硬湊百分比只會做出一個好看卻站不住腳的數字。真正能對照的,是 Day 29 用同一套驗收條件、各 8 筆紀錄跑出的結果:
| 指標 | 基準線(人工) | AI 協作 | 差異 |
|---|---|---|---|
| 平均生成到定稿時間 | 104.0 分鐘 | 62.0 分鐘 | -40% |
| 平均複核時間 | 21.1 分鐘 | 28.5 分鐘 | +7.4 分鐘 |
| 大幅修改或否決比例 | 25.0% | 37.5% | +12.5 個百分點 |
| 平均引用錯誤數 | 0.25 | 1.00 | 約 4 倍 |
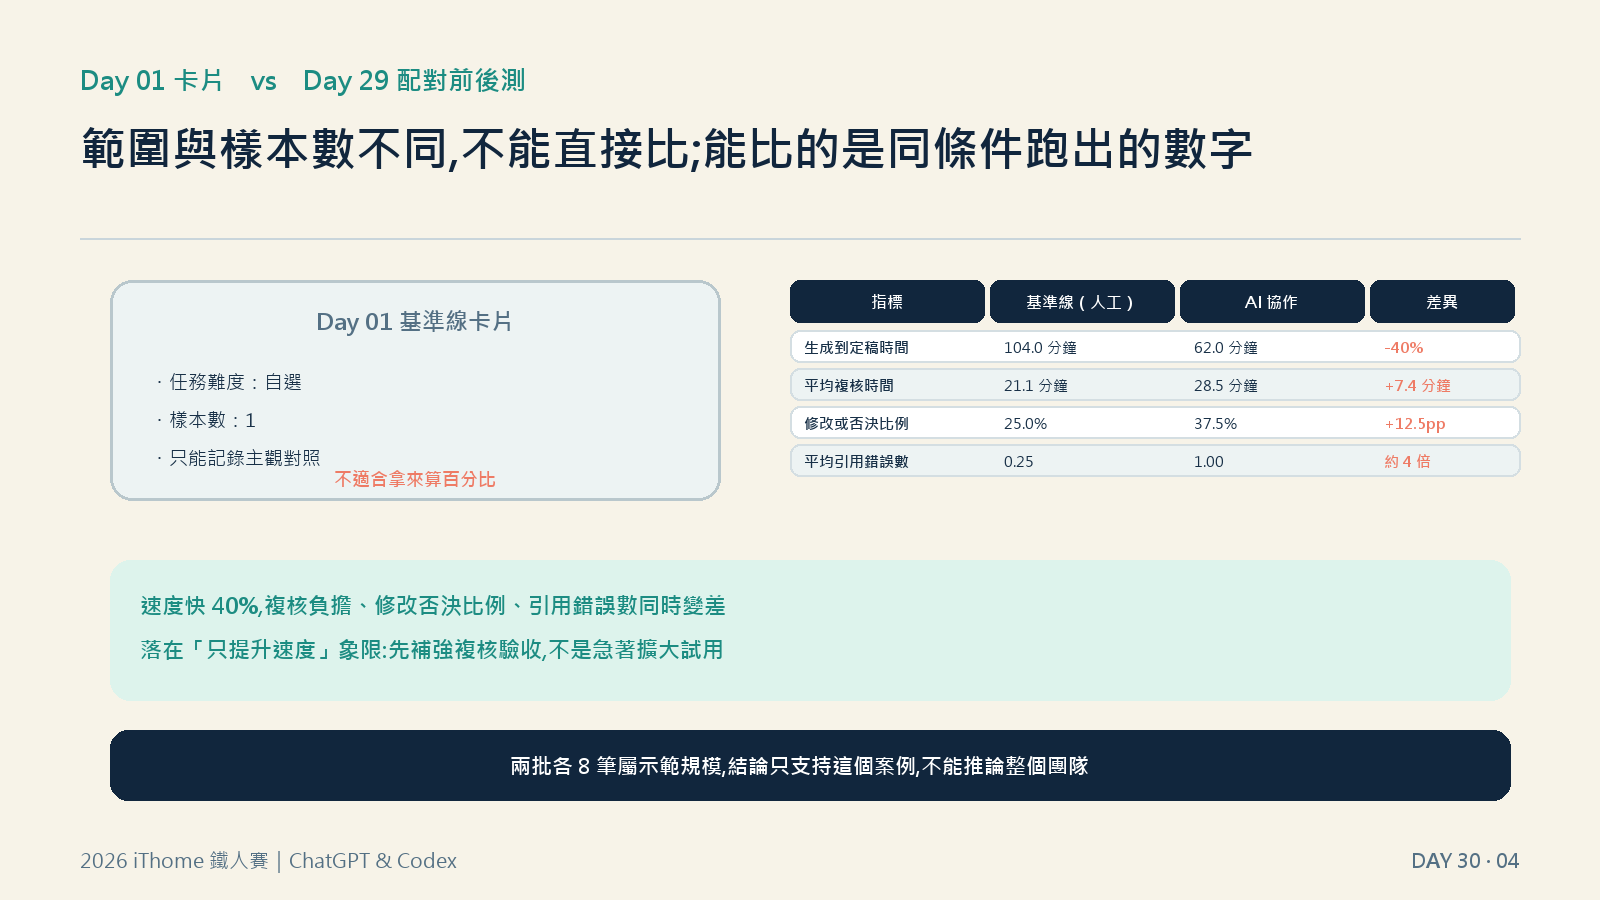
速度變快四成,複核負擔、修改否決比例、引用錯誤數卻同時變差,落在 Day 29 定義的「只提升速度」那格,該做的是補強複核驗收,不是急著擴大試用。兩批各 8 筆屬示範規模,不足以做統計顯著性檢定,這個結論只支持 Day 29 那個案例,不能直接推論到整個團隊或其他任務類型。
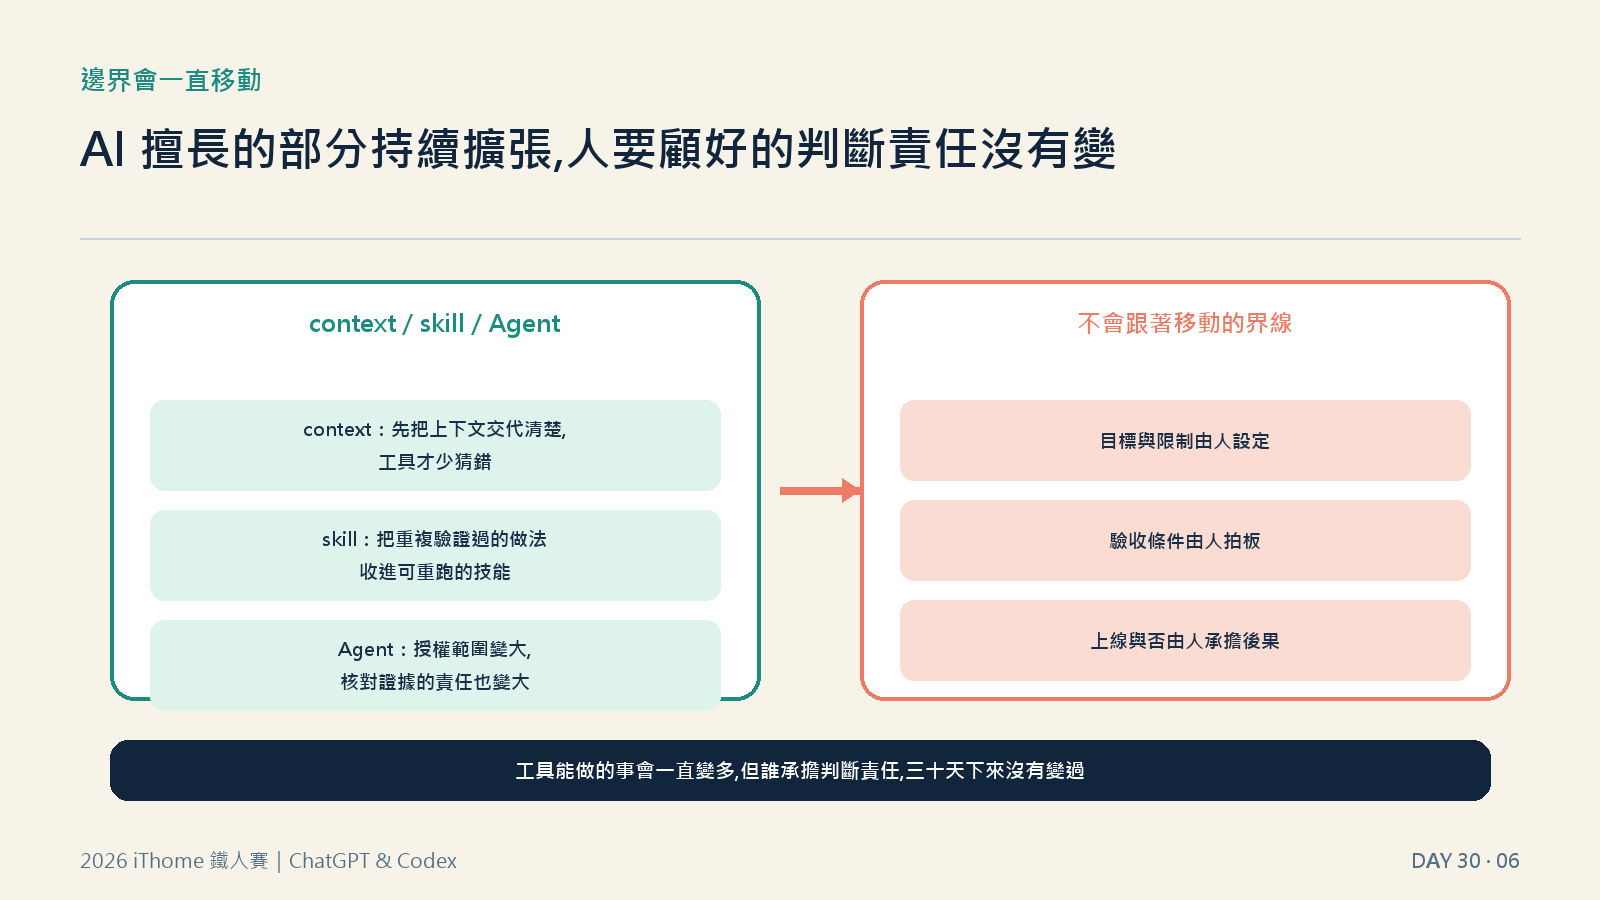
三十天走下來,ChatGPT 與 Codex 能碰的範圍一直在擴大:從整理文字、比較方案,到直接讀寫專案、執行測試、開分支。往前看,context(把任務背景交代清楚)、skill(把驗證過的做法收進可重跑的技能)、Agent(讓代理在更大授權範圍內連續行動)這三層能力還會繼續往前推進,讀者不必等它們穩定下來才開始用,但每往前一步,都該搭配對應的核對習慣——context 給得越完整,越要盯緊機密與範圍;skill 收得越多,越要定期重跑驗證,不能收進去就不再檢查;Agent 授權得越大,越要留住能追回的證據鏈,而不是只看最後一句「已完成」。這三層要怎麼取捨、什麼時候該往前推、什麼時候該先踩煞車,答案會隨著工具能力持續改變,沒有一次寫定的公式。
會移動的是工具能碰到的範圍,不會移動的是目標、限制、驗收與是否上線這幾件事,仍然由人拍板。
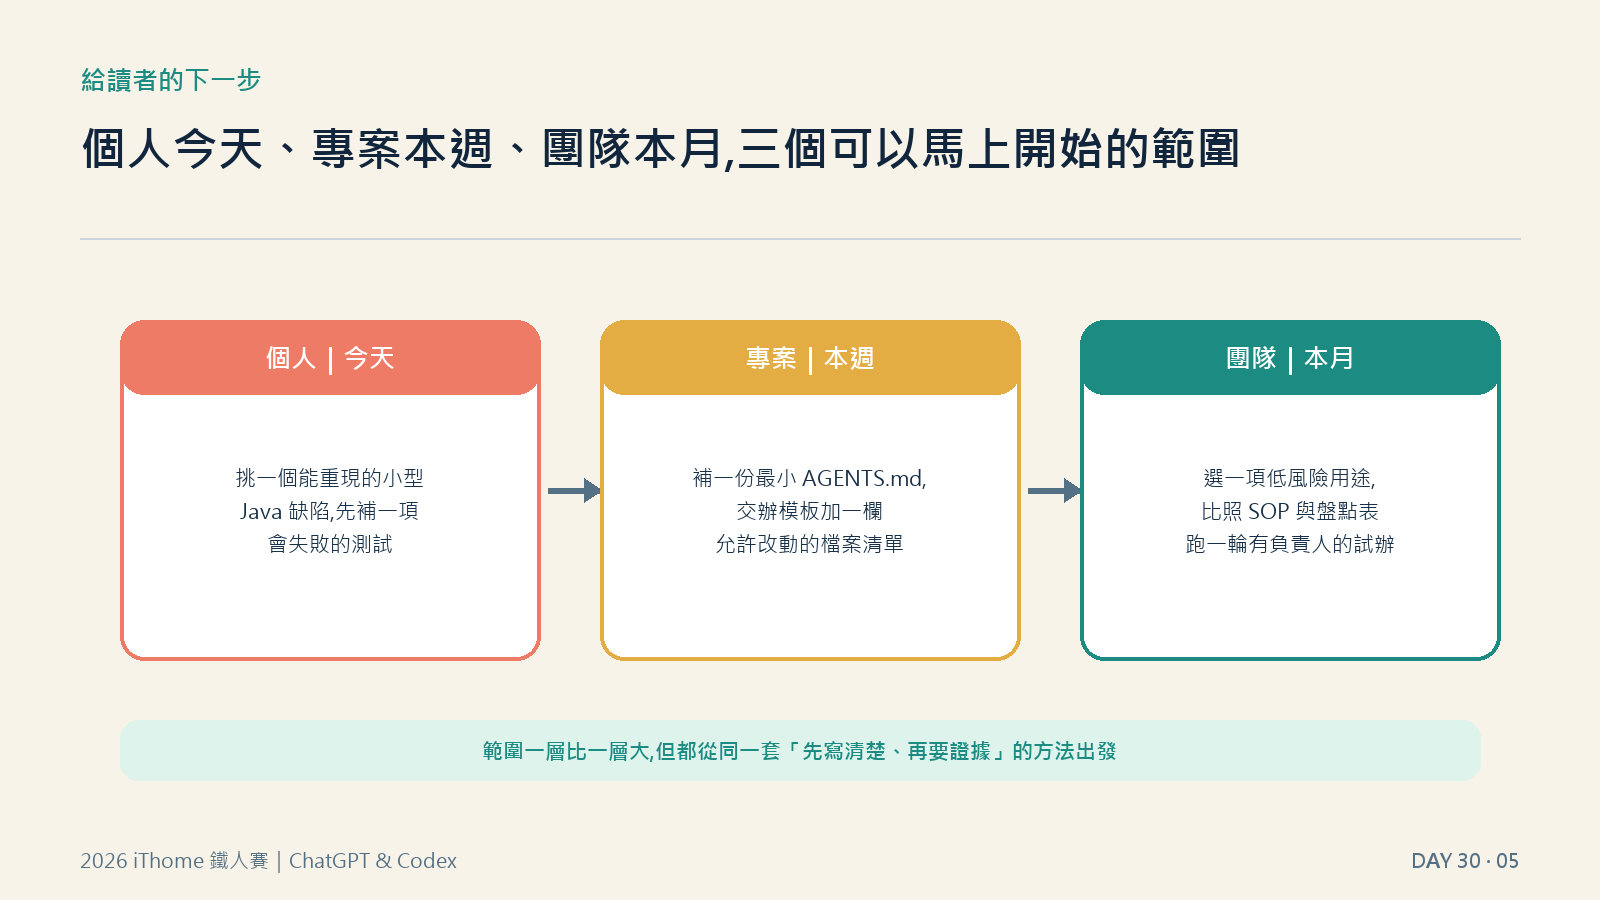
AGENTS.md,並在交辦模板加一欄「允許改動的檔案清單」,對應 Day 12 與 Day 18 學到的教訓。第一,ChatGPT 與 Codex 的介面、方案與模型版本持續更新,Day 03 寫的最小可用環境,發文當下就得重新核對官方文件,這件事沒有終點。第二,Day 29 的樣本數只有 8,長期缺陷率、返工率是否真的下降,要更多配對批次累積下去才禁得起檢驗;下一步是把方法留下來,按季重跑並累積樣本。第三,Day 27 的存取控制程式碼證明「規則可以寫進系統」,但沒人追蹤執行率就形同沒做;下一步靠稽核紀錄,由治理負責人按季稽核,不是靠工程師自律。
三十天下來,我沒有找到一個可以替我承擔判斷的工具。我找到的是一套更清楚交代工作、要求證據、保留人工判斷的方法——決策白名單、issue 補成可重跑的修正說明、diff 對照允許清單、指標配上品質護欄。這套方法比任何一次「AI 很強大」的印象都更值得帶進明天的開發工作。謝謝讀完這三十篇的你,如果你也開始在自己的專案上試著寫一份 AGENTS.md,或是把提示詞的六個欄位填滿再送出,這個系列就達到它原本想做的事。
本系列 Day 01–29 文章、程式碼與驗證紀錄
ChatGPT 中 Codex 文件


 iThome鐵人賽
 看影片追技術